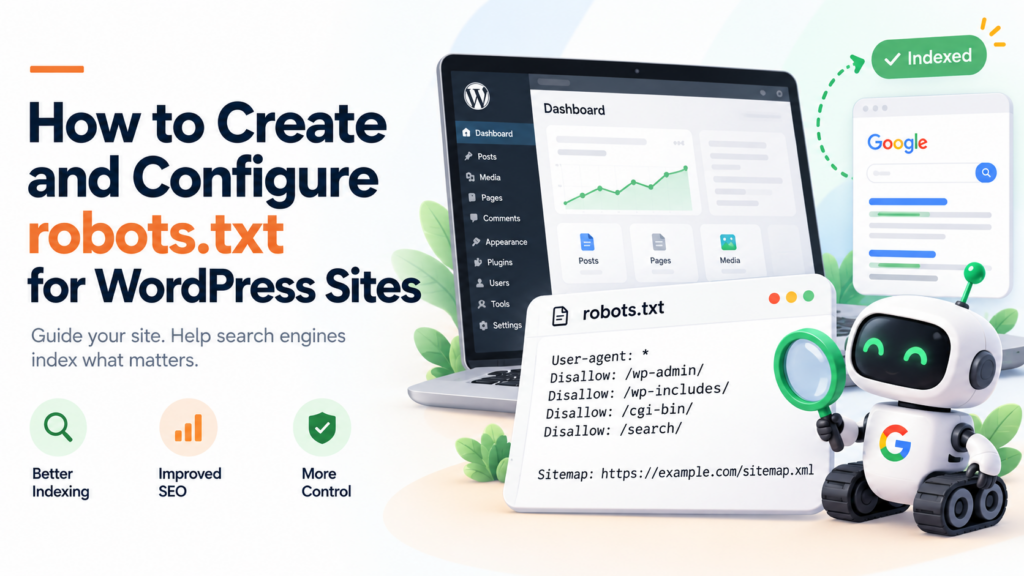
Een robots.txt-bestand is klein, maar bepaalt welke delen van je WordPress-website crawlers mogen bezoeken. Met een goede configuratie houd je zoekmachines weg van URL’s zonder toegevoegde waarde en verwijs je ze naar de XML-sitemap. Een verkeerde regel kan juist belangrijke pagina’s of benodigde bronnen blokkeren.
WordPress kan automatisch een virtuele robots.txt genereren. Je kunt daarnaast een fysiek bestand in de hoofdmap van de website plaatsen. Deze handleiding legt uit wanneer je welke variant gebruikt en welke regels veilig zijn voor blogs, webshops en stagingomgevingen.
Wat doet robots.txt?
Wanneer een crawler je website bezoekt, kan hij eerst het bestand op het hoofddomein ophalen:
https://example.com/robots.txtEen eenvoudige WordPress-configuratie ziet er bijvoorbeeld zo uit:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/wp-sitemap.xml
User-agent: * richt de regels op alle crawlers die het protocol volgen. Disallow blokkeert crawling van een pad, Allow maakt een uitzondering en Sitemap verwijst naar de volledige sitemap-URL.
Crawling en indexering zijn niet hetzelfde
Een URL blokkeren in robots.txt betekent niet automatisch dat hij nooit in Google verschijnt. Als andere websites naar de geblokkeerde URL verwijzen, kan Google weten dat hij bestaat en hem soms zonder inhoud tonen.
Gebruik voor gewone openbare pagina’s die niet in zoekresultaten horen doorgaans een noindex-instructie terwijl crawling mogelijk blijft. Bescherm vertrouwelijke informatie met authenticatie, een wachtwoord of toegangsregels. robots.txt is openbaar en is geen beveiligingsmechanisme.
robots.txt en crawlbudget
Voor kleine en middelgrote WordPress-websites is uitgebreid crawlbudgetbeheer meestal niet nodig. Een actuele sitemap en goede indexeringscontrole zijn belangrijker dan een lange lijst met blokkades.
robots.txt wordt vooral relevant wanneer een website zeer veel URL-combinaties kan genereren. Webshopfilters voor maat, prijs, kleur, merk en sortering kunnen bijvoorbeeld duizenden varianten opleveren. Wanneer deze varianten niet in zoekresultaten hoeven te staan, kan gerichte crawlsturing serverbelasting en verspilde crawling beperken.
Virtuele en fysieke robots.txt in WordPress
De virtuele WordPress-versie
WordPress kan het antwoord op /robots.txt dynamisch genereren. De basis bevat doorgaans:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Plugins en WordPress zelf kunnen de uitvoer via filters uitbreiden. De ingebouwde sitemapfunctionaliteit kan bijvoorbeeld automatisch het sitemapadres toevoegen.
Een fysiek robots.txt-bestand
Een fysiek bestand staat in de publiek bereikbare documentroot. Zodra de webserver dit bestand rechtstreeks serveert, krijgt WordPress mogelijk niet meer de kans zijn virtuele versie te genereren.
Voeg daarom in een handmatig bestand zelf de juiste Sitemap:-regel toe. Controleer altijd de live uitvoer in een privévenster; hosting, beveiligingslagen en SEO-plugins kunnen het resultaat beïnvloeden.
robots.txt maken of wijzigen
Open eerst de huidige versie:
https://jouwdomein.nl/robots.txtBewaar een kopie voordat je iets wijzigt. Kies daarna één beheerroute.
Via een SEO-plugin
Sommige SEO-plugins bieden een editor voor robots.txt. Dit is gebruiksvriendelijk, maar controleer of de plugin een fysiek bestand schrijft of de virtuele WordPress-uitvoer aanpast. Gebruik niet meerdere robots-editors tegelijk.
Via hosting of bestandsbeheer
- Open de documentroot van het juiste domein.
- Maak een tekstbestand met exact de naam
robots.txt. - Gebruik UTF-8 en gewone tekst, zonder opmaak.
- Voeg de gewenste regels en volledige sitemap-URL toe.
- Upload of bewaar het bestand en controleer de publieke URL.
Via FTP of SFTP
Verbind veilig met de server, open de webroot en download eerst de bestaande versie. Upload daarna het gecontroleerde bestand. Controleer dat het bestand niet per ongeluk robots.txt.txt heet.
Een veilige basisconfiguratie
Voor een normale publieke WordPress-website is dit vaak voldoende:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Sitemap: https://example.com/wp-sitemap.xml
Vervang de sitemap-URL door de werkelijke sitemap van WordPress of je SEO-plugin. Voeg niet zonder reden allerlei mappen toe.
Regels die je meestal niet moet kopiëren
Blokkeer niet de volledige wp-content-map
Thema’s, CSS, JavaScript, afbeeldingen en fonts staan vaak onder /wp-content/. Google heeft deze bronnen nodig om pagina’s goed te renderen en begrijpen.
Blokkeer belangrijke pagina’s niet om indexering te voorkomen
Gebruik robots.txt niet als vervanging voor noindex. Een blokkade kan voorkomen dat Google de noindex-instructie op de pagina leest.
Gebruik geen algemene regels voor trackingparameters zonder analyse
Parameters kunnen tracking, filtering of essentiële applicatiefuncties ondersteunen. Controleer eerst welke URL’s werkelijk ontstaan en of ze moeten worden gecrawld of geïndexeerd.
robots.txt voor webshops
WooCommerce en filterplugins kunnen veel URL-varianten maken. Analyseer eerst de daadwerkelijke parameterpatronen. Houd product- en categoriepagina’s toegankelijk en blokkeer alleen duidelijk overbodige combinaties.
Combineer crawlregels met canonicals, noindex waar passend en een sitemap die uitsluitend voorkeurs-URL’s bevat. robots.txt alleen lost duplicatie niet op.
Stagingomgevingen goed beschermen
Een regel als Disallow: / is geen betrouwbare privacybescherming. Beveilig staging met HTTP-authenticatie, een wachtwoord, IP-beperking of een andere echte toegangscontrole. Voeg daarnaast noindex toe als extra laag, maar vertrouw niet uitsluitend op robots.txt.
Je robots.txt testen
- Open de live robots.txt terwijl je bent uitgelogd.
- Controleer of het bestand HTTP-status 200 retourneert.
- Test of de sitemap-URL werkt en de juiste URL’s bevat.
- Controleer belangrijke pagina’s en benodigde CSS-, JavaScript- en afbeeldingsbestanden.
- Gebruik URL-inspectie en robots-controles in Google Search Console.
- Controleer subdomeinen afzonderlijk; ieder hostadres heeft zijn eigen robots.txt.
- Leeg server- en CDN-cache wanneer de oude versie zichtbaar blijft.
Veelgestelde vragen
Maakt WordPress automatisch robots.txt aan?
WordPress kan dynamisch robots.txt-uitvoer genereren. De uitvoer kan door WordPress en plugins worden uitgebreid.
Heb ik een fysiek bestand nodig?
Meestal niet. Gebruik een fysiek bestand wanneer je hostingarchitectuur of beheerproces dit vereist, of wanneer je bewust buiten WordPress wilt beheren.
Moet ik /wp-admin/ blokkeren?
WordPress doet dit standaard en laat /wp-admin/admin-ajax.php expliciet toe. Dat is voor de meeste websites een goede basis.
Moet ik /wp-content/ blokkeren?
Nee, niet als algemene regel. Deze map bevat vaak bronnen die zoekmachines nodig hebben om de website te renderen.
Kan robots.txt een pagina uit Google verwijderen?
Vertrouw daar niet op. Gebruik noindex voor openbare pagina’s die niet in de resultaten horen en echte toegangsbeveiliging voor privé-informatie.
Conclusie en checklist
- Houd waardevolle pagina’s en renderbronnen toegankelijk.
- Blokkeer alleen URL-patronen met een duidelijke reden.
- Verwijs naar de correcte absolute sitemap-URL.
- Gebruik noindex voor indexeringssturing en authenticatie voor privé-inhoud.
- Test na iedere wijziging de publieke uitvoer en belangrijke URL’s.
De beste robots.txt is zelden de langste. Voor de meeste WordPress-websites zijn enkele weloverwogen regels veiliger dan een uitgebreide configuratie die van een willekeurige website is gekopieerd.
Bronnen en verdere informatie
- Google: robots.txt maken en indienen
- WordPress: do_robots()
- Google robots.txt-specificatie
- Google: indexering en privé-inhoud beheren
- Google over crawlbudget
Plan een gesprek over je website
Wil je weten welke technische verbeteringen het meeste effect hebben? Bespreek je website met QuickWebify.